Голосовой поиск меняет то, как пользователи в Юго-Восточной Азии взаимодействуют с контентом, и требует от технического SEO адаптации к местным языковым и культурным особенностям. Поскольку растёт число разговорных запросов в форме вопросов, бизнесу необходимо сохранять видимость, оптимизируя контент под эти модели поведения.
Культурные и многоязычные нюансы, такие как переключение кодов, местный сленг и диалектные вариации, влияют на то, как интерпретируются поисковые запросы. Стратегии SEO должны быть сосредоточены на естественном языке, длинных запросах и правильной технической настройке, такой как разметка схемы и многоязычная индексация.
Тенденции внедрения и ключевые рынки голосового поиска в Юго-Восточной Азии
Тенденция внедрения голосового поиска в Юго-Восточной Азии демонстрирует значительный рост, отражая изменения в поведении потребителей, которые всё чаще полагаются на голосовые технологии в повседневной жизни. Такие страны, как Индонезия, Таиланд, Филиппины и Вьетнам, являются основными рынками, движущими эту тенденцию, чему способствуют растущее проникновение интернета и технологически подкованная молодая аудитория. Данные Digital Market показывают, что пользователи всё чаще переходят от текстового поиска к голосовому, используя полные предложения и разговорные фразы.
Согласно данным Demand Sage, примерно 20,5% пользователей интернета в мире используют голосовой поиск, а общее число активных голосовых помощников достигнет 8,4 миллиарда единиц к 2025 году. Хотя конкретных данных по Юго-Восточной Азии нет, эта глобальная тенденция указывает на то, что регион вносит значительный вклад в этот рост.
Крупные технологические компании, такие как Google, Amazon и Microsoft, увеличили свои инвестиции в Юго-Восточную Азию, что отражает их уверенность в потенциале рынка. Например, Google объявила об инвестициях в размере 2 миллиардов долларов на строительство центров обработки данных и облачных сервисов в Малайзии, что будет поддерживать сервисы голосового поиска.
Таким образом, несмотря на такие проблемы, как языковое и диалектное разнообразие, рыночный потенциал голосового поиска в Юго-Восточной Азии огромен, и компании, способные адаптировать свои стратегии к местным потребностям, получат значительное конкурентное преимущество.
Культурные и многоязычные нюансы, формирующие голосовые запросы
Культурное и языковое разнообразие оказывает глубокое влияние на поведение при голосовом поиске в Юго-Восточной Азии. Пользователи часто сочетают языки, диалекты и неформальную речь так, как это отражает их повседневное общение, что создаёт уникальные сложности для поисковых систем при точной интерпретации запросов. Понимание этих нюансов критически важно для оптимизации контента под голосовой поиск.
Переключение языков в повседневной речи
В Юго-Восточной Азии люди часто переключаются между языками в середине предложения, например, сочетая местный язык с английским. Такое переключение кода происходит естественно в разговоре и влияет на то, как поисковые системы интерпретируют голосовые запросы. Запрос может содержать ключевые слова из двух языков, поэтому контенту важно учитывать оба.
Стратегии поисковой оптимизации должны включать фразы на смешанных языках в ключевом контенте, заголовках и метаданных. Понимание распространённых моделей переключения языков гарантирует, что запросы на любом из языков смогут выдавать релевантные результаты, повышая общую видимость и удовлетворённость пользователей.
Диалекты, акценты и неформальные языковые модели
Региональные диалекты и акценты могут значительно изменять произношение, что приводит к неверной интерпретации в системах распознавания речи. Неформальная речь, включая сокращения или местные выражения, добавляет ещё один уровень сложности. Поисковые системы могут испытывать трудности с правильным сопоставлением таких запросов со стандартным контентом.
Чтобы решить эту проблему, создатели контента могут включать альтернативные написания, фонетические вариации или разговорные выражения в контент и метаданные. Такой подход помогает обеспечить правильное понимание и сопоставление голосовых запросов из разных регионов, повышая точность поиска для всех аудиторий.
Смешение английского с местным сленгом в запросах
Многие пользователи смешивают английские слова с местным сленгом в своих поисковых запросах, особенно в темах, связанных с технологиями, развлечениями или товарами. Например, пользователь может написать: «Best gadget murah di Jakarta», объединяя английский и индонезийский языки. Игнорирование таких гибридных форм может привести к упущенным возможностям для поиска.
Оптимизация контента для голосового поиска требует выявления часто используемого сленга и включения его наряду со стандартными языковыми терминами. Это позволяет поисковым системам более эффективно сопоставлять разговорные запросы, повышая вероятность появления в результатах для поиска на смешанных языках.
Сокращённые фразы против запросов в виде полных предложений
В отличие от текстовых запросов, голосовые запросы часто представляют собой целые предложения, а не отдельные ключевые слова. Пользователи могут спросить: «Где найти дешёвый наси лемак в Куала-Лумпуре?» вместо того, чтобы вводить «дешёвый наси лемак KL». Этот сдвиг в сторону более разговорных формулировок меняет то, как следует структурировать контент, чтобы давать прямые ответы.
Чтобы адаптироваться, контент должен предлагать краткие ответы на естественном языке и включать заголовки в виде вопросов или разделы часто задаваемых вопросов. Формулирование ответов в виде полных предложений повышает вероятность того, что голосовые помощники смогут извлечь и предоставить пользователям точные результаты.
Использование вежливых форм и гоноративов в местных языках
В некоторых языках Юго-Восточной Азии, например тайском или яванском, пользователи включают в свои голосовые запросы вежливые формы или гоноративы. Это особенно распространено при обращении к устройствам, воспринимаемым как «формальные», или в общественных местах. Игнорирование этих форм может снизить точность поиска.
Создателям контента следует рассмотреть возможность включения вежливых формулировок или альтернативных вариантов там, где это уместно. Это помогает соответствовать намерению пользователя, гарантируя, что запросы, содержащие вежливые выражения, по-прежнему приводят к точным и релевантным результатам.
Религиозная и культурная терминология в поисковых намерениях
Пользователи часто используют религиозные или культурные термины при голосовом поиске, отражая местные обычаи, праздники или ритуалы. Запросы могут включать такие фразы, как «рецепт для Рамадана» или «часы работы храма на Бали», которые могут не появляться в стандартном исследовании ключевых слов для SEO.
Включение культурно значимой терминологии и контекста в контент помогает соответствовать этим намерениям пользователей. Компании и создатели контента могут повысить видимость, предугадывая запросы, обусловленные культурными особенностями, и предоставляя прямые ответы в контенте, адаптированном к местным контекстам.
Вариации произношения, влияющие на ASR
Автоматическое распознавание речи (ASR) может неправильно интерпретировать слова из-за региональных или возрастных различий в произношении. Например, слово, произнесённое в Джакарте, может звучать немного иначе в Сурабае или Пенанге, что может привести к ошибкам при сопоставлении голосовых запросов.
Чтобы смягчить эту проблему, создатели контента могут учитывать распространённые варианты произношения, включать фонетические написания или использовать контент в формате часто задаваемых вопросов, отражающий естественную речь. Это гарантирует, что голосовые запросы будут правильно распознаны и сопоставлены с релевантным контентом, что повышает эффективность поиска среди разных групп пользователей.
Технические SEO-задачи в голосовом поиске
Голосовой поиск создает уникальные технические SEO проблемы, поскольку запросы часто длиннее, разговорнее и многоязычны. Чтобы контент был доступен для обнаружения, правильно проиндексирован и структурирован для прямых ответов, требуется тщательная оптимизация. Бизнесу необходимо адаптировать свои SEO-стратегии, чтобы соответствовать этим меняющимся требованиям.
Работа с длинными и разговорными запросами
Голосовые запросы обычно длиннее, чем поисковые запросы, вводимые с клавиатуры, и часто имеют форму естественных предложений. Это создает проблемы для SEO, поскольку стандартный таргетинг по ключевым словам может не охватывать все разнообразие формулировок вопросов пользователей. Контент, ориентированный только на короткие ключевые слова, может упустить ценный трафик из голосового поиска.
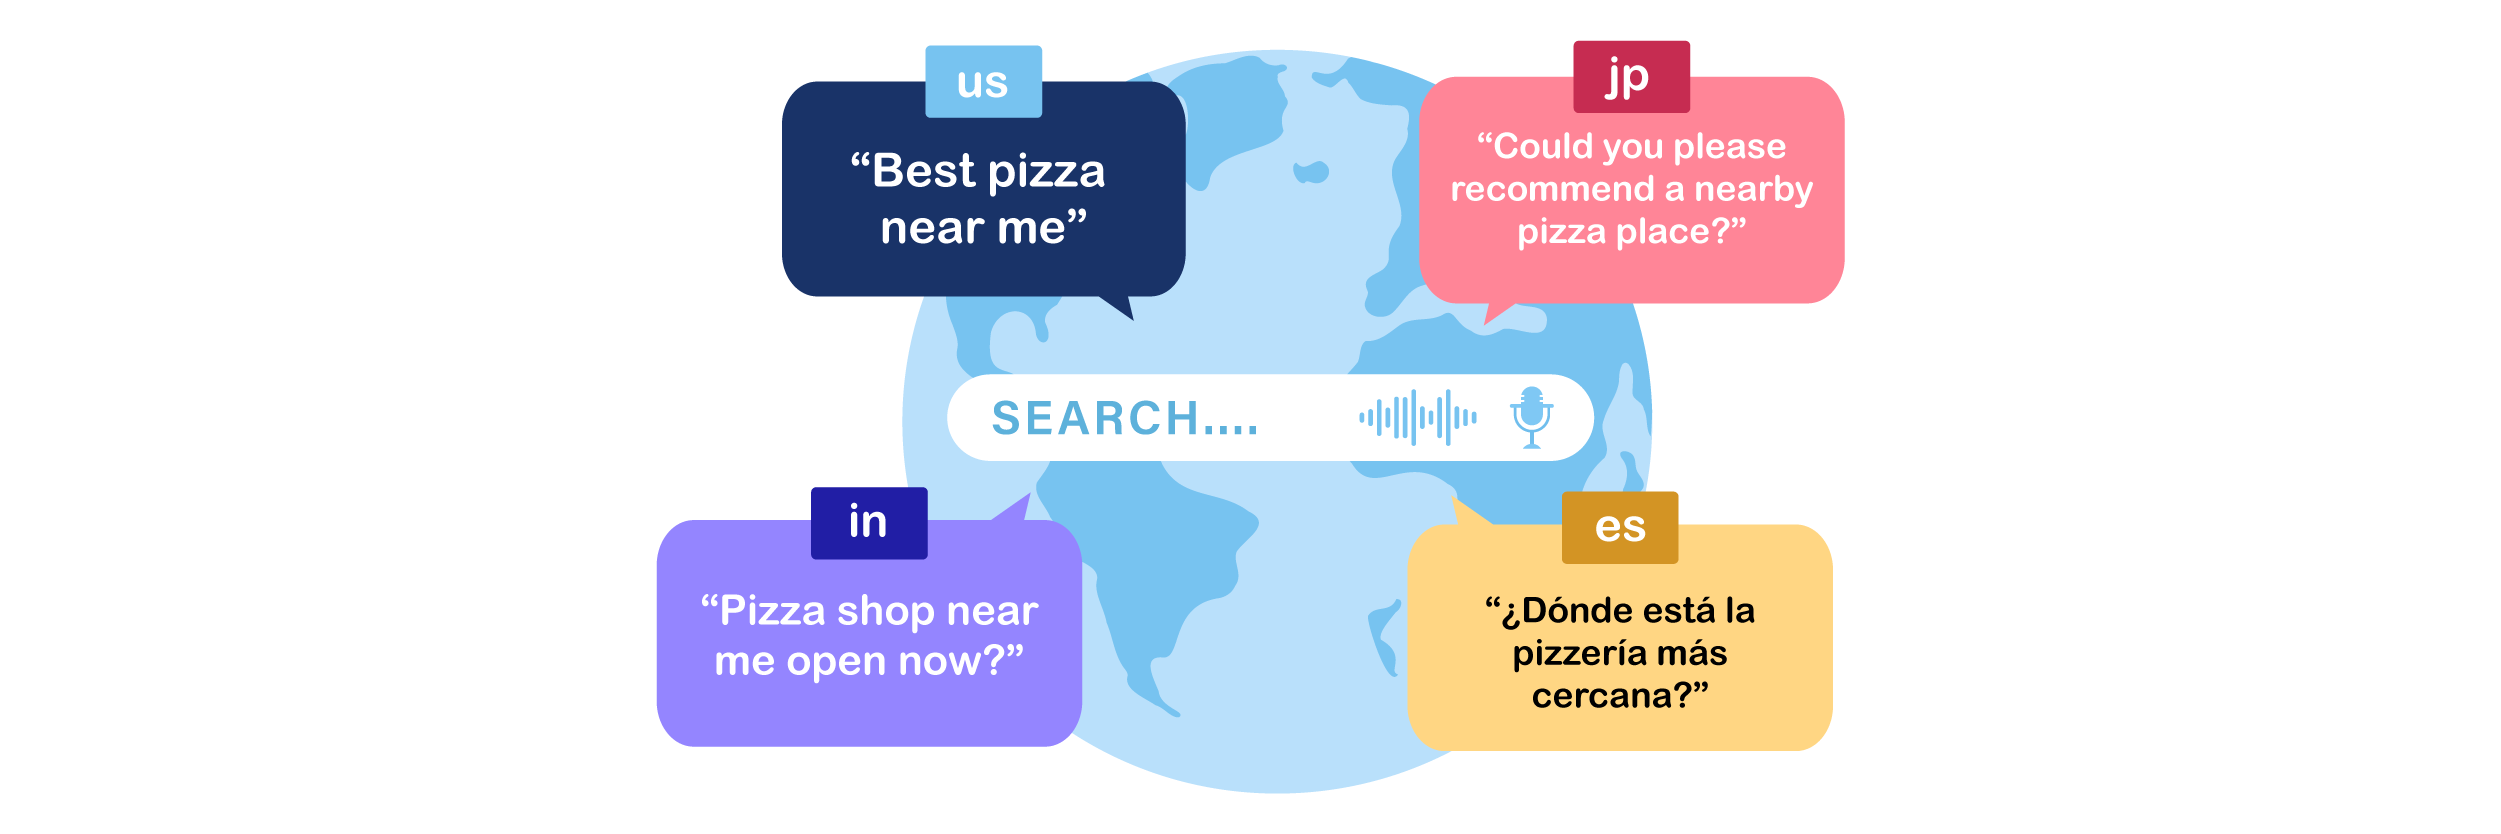
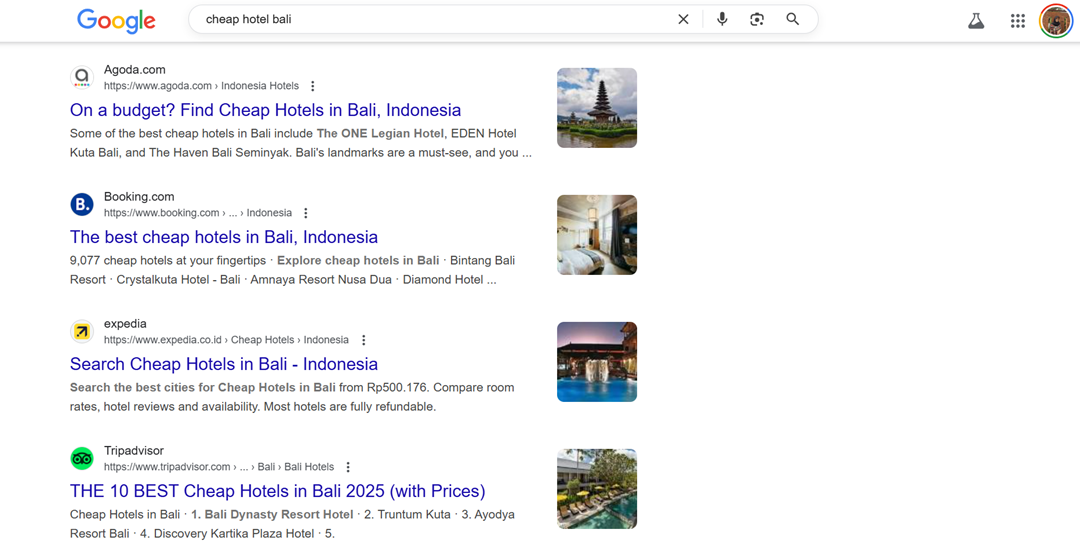
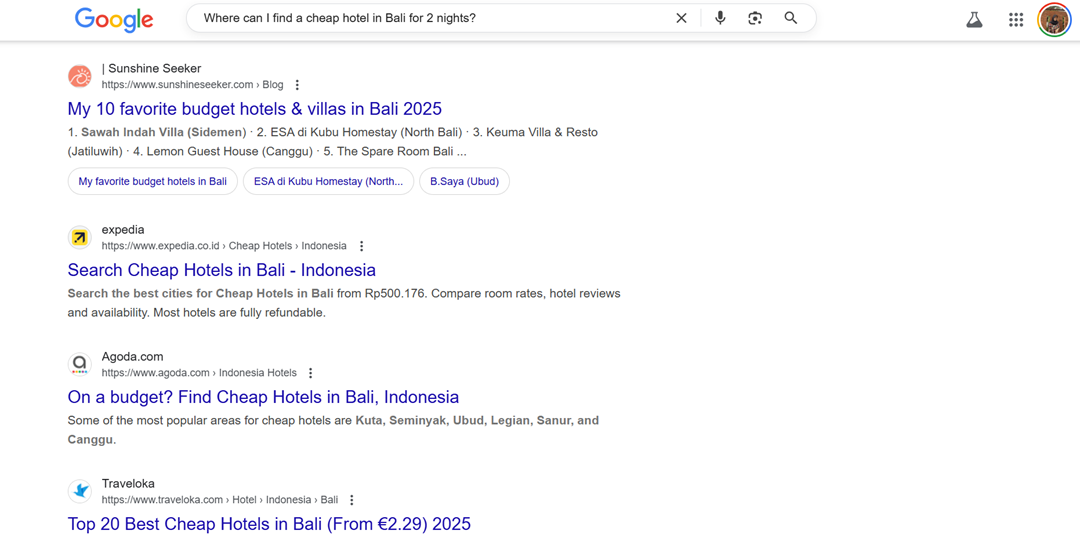
На скриншоте ниже показана разница между текстовыми запросами, такими как «дешёвый отель Бали», и голосовыми запросами с полными предложениями, такими как «Где я могу найти дешёвый отель на Бали на 2 ночи?».
Хотя у обоих одна и та же цель, языковая структура сильно различается, и если контент оптимизирован только под короткие ключевые слова, результаты разговорного поиска, подобные этому, могут быть упущены.
Чтобы решить эту проблему, веб-сайтам следует интегрировать низкочастотные ключевые слова, отражающие запросы в виде полных предложений. Анализ реальных запросов пользователей и обновление контента с включением разговорной лексики помогает поисковым системам лучше сопоставлять запросы с релевантными страницами, повышая видимость для голосового поиска.
Структурирование контента для прямых ответов
Голосовые помощники отдают предпочтение контенту, который даёт чёткие и краткие ответы. Одна из задач — структурировать информацию так, чтобы её было легко извлечь и прочитать вслух. Платформы голосового поиска могут игнорировать страницы с плотными абзацами или нечётким форматированием.
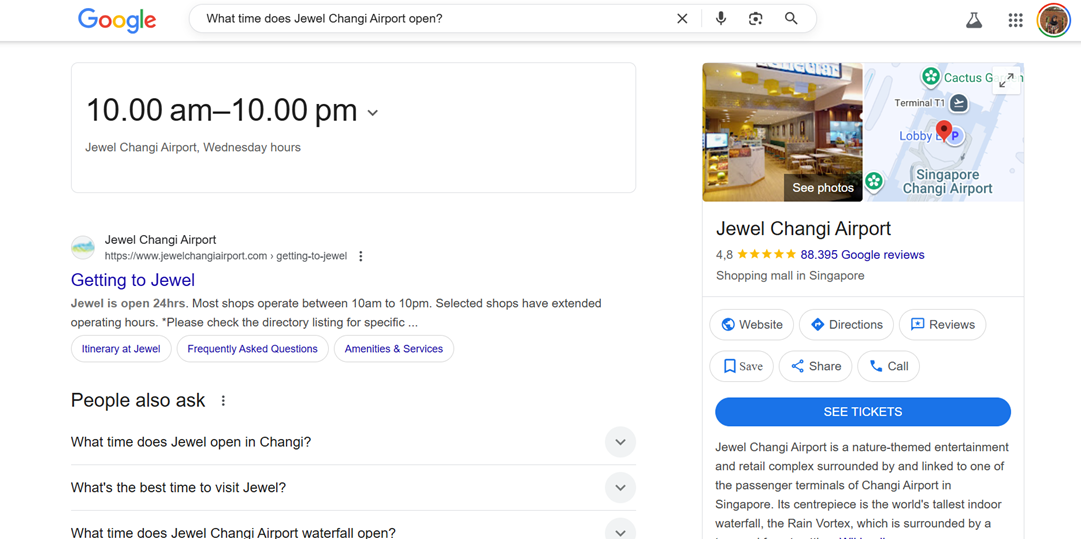
Использование заголовков, маркированных списков и коротких абзацев помогает контенту выделиться в качестве прямого ответа. Разделы часто задаваемых вопросов и выделенные резюме упрощают поисковым системам задачу определения наиболее релевантной информации, повышая шансы на попадание в голосовые ответы. Например, при поиске в Google одного из следующих ключевых слов: «Во сколько открывается аэропорт Джуэл Чанги?» — сразу появится фрагмент с часами работы и соответствующими часто задаваемыми вопросами.
Оптимизация под поисковые запросы в форме вопросов
Многие голосовые запросы формулируются как вопросы, например: «Как добраться до храма Танах Лот?» Традиционное SEO часто ориентируется на ключевые слова, а не на интент вопроса, что ограничивает видимость. Это создает проблему прогнозирования и оптимизации для различных возможных запросов.
Чтобы преодолеть это, контент следует создавать с включением форматов «вопрос-ответ». Использование заголовков, имитирующих распространённые вопросы, и естественное интегрирование ответов обеспечивает точное соответствие голосовых запросов контенту, повышая релевантность поиска.
Улучшение сканируемости и индексируемости для разных языков
Многоязычный контент усложняет техническую SEO-оптимизацию для голосового поиска. Обеспечить возможность поисковых систем сканировать и индексировать страницы на нескольких языках непросто, особенно если сайты используют разные URL-адреса или поддомены для локализованного контента.
Правильные теги hreflang, карты сайта для конкретных языков и чистые структуры URL помогают поисковым системам понимать языковое и региональное таргетирование. Это улучшает индексируемость и гарантирует, что пользователи получают наиболее релевантные результаты на предпочитаемом языке.
Управление дублирующимся контентом в локализованных версиях
Дублирование контента может возникать, когда похожие страницы создаются на разных языках или в разных регионах. Это серьёзная проблема, поскольку поисковым системам может быть сложно определить, какую версию ранжировать, что снижает видимость для голосового поиска. Использование канонических тегов и обеспечение того, чтобы каждая локализованная страница содержала уникальный, релевантный контент, помогает смягчить эту проблему. Правильное разграничение контента гарантирует, что голосовые запросы направляются на наиболее подходящую страницу, сохраняя пользовательский опыт и эффективность поиска.
Однако управлять этим вручную для десятков языковых версий может быть трудоемко.
Решение для перевода и локализации, такое как Linguise , автоматически создает SEO-дружественные URL-адреса, применяет канонические теги и гарантирует, что каждая переведенная версия рассматривается как уникальная страница, а не дублирующийся контент, что позволяет компаниям масштабировать оптимизацию многоязычного голосового поиска без риска конфликтов индексации.
Преодолейте языковые барьеры
Попрощайтесь с языковыми барьерами и откройте безграничный рост! Попробуйте наш сервис автоматического перевода уже сегодня.
Покрытие схемы разметки для голосовых результатов поиска
Голосовой поиск часто опирается на структурированные данные, чтобы быстро находить релевантные ответы. Задача состоит в том, чтобы обеспечить разметку схемы последовательно на всех страницах, включая многоязычный контент и локализованные версии.
Использование типов схем, таких как FAQ, HowTo и Product, упрощает поисковым системам извлечение информации для голосовых ответов. Регулярный аудит и обновление структурированных данных помогают поддерживать точность и повышать видимость в результатах голосового поиска.
Контент-стратегия для оптимизации под голосовой поиск
Оптимизация контента для голосового поиска требует отказа от традиционных методов поисковой оптимизации. Поскольку голосовые запросы носят разговорный характер и часто формулируются в виде вопросов, контент должен быть структурирован так, чтобы естественно отвечать на вопросы, легко восприниматься и отражать реальные намерения пользователей. Стратегический подход гарантирует, что контент будет находиться и хорошо ранжироваться по голосовым запросам.
Оптимизация под естественный язык и ключевые слова в виде вопросов
Голосовые поисковые запросы часто формулируются полными предложениями, а не короткими ключевыми словами. Поэтому крайне важно ориентироваться на фразы естественного языка и ключевые слова в форме вопросов, например «Где найти лучший кофе во Франции?», а не просто «лучший кофе Франция»
Включение этих фраз в заголовки, разделы часто задаваемых вопросов и основной текст помогает поисковым системам сопоставлять разговорные запросы. Например, туристический сайт может создать страницу с часто задаваемыми вопросами, отвечающую на вопрос «Какие главные достопримечательности в Убуде?», чтобы напрямую привлекать трафик из голосового поиска.
Локализация контента выходит за рамки перевода
Пользователи часто ищут на родном языке и ожидают культурно релевантный контент. Простого перевода контента недостаточно; локализация контента должна адаптировать примеры, валюту, единицы измерения и контекст к местным обычаям.
Например, сайт с рецептами, ориентированный на Малайзию, должен использовать местные названия ингредиентов и меры, знакомые малайзийским пользователям, а не буквальные переводы. Такой подход повышает вовлеченность и гарантирует, что голосовой поиск выдает значимые результаты.
Создавайте форматы, удобные для голосового поиска
Контент должен быть структурирован так, чтобы голосовые помощники могли легко читать его вслух. Короткие абзацы, маркированные списки, нумерованные шаги и четкие заголовки помогают голосовым помощникам эффективно извлекать информацию.
Например, руководство «Как посетить Gardens by the Bay» с пронумерованными указаниями от станции метро Bayfront и ключевыми советами в виде маркированного списка позволяет пользователям получать краткие голосовые инструкции, что повышает удобство использования для голосового поиска.
Используйте разговорный тон, не теряя авторитета
Пользователи голосового поиска ожидают естественного и понятного тона. Однако контент также должен сохранять достоверность и авторитетность, особенно в технических, медицинских или финансовых темах. Слишком неформальное написание может ослабить доверие, а слишком формальное — звучать роботизированно, поэтому важно найти правильный баланс между разговорным и информативным стилем.
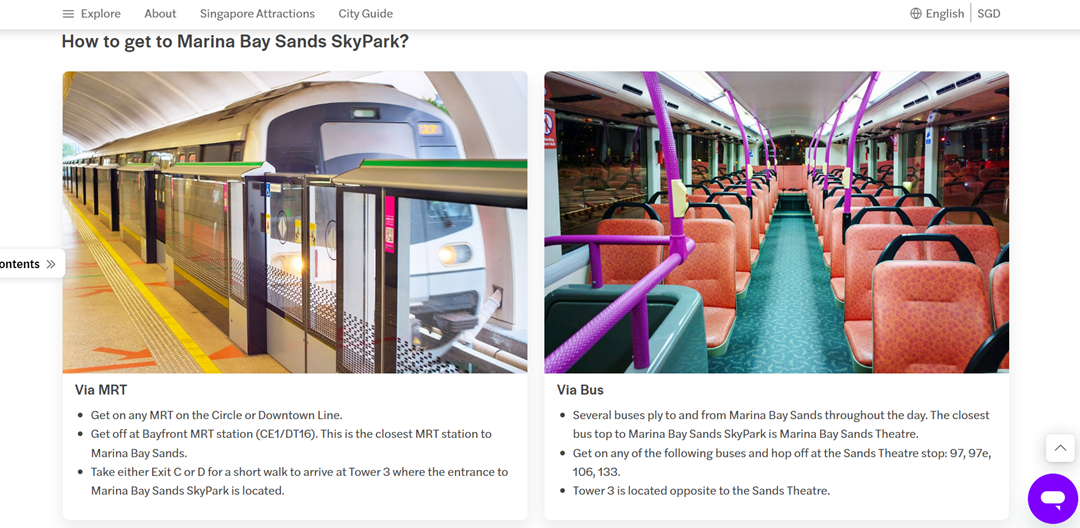
Вместо того чтобы описывать маршрут к такому месту, как Marina Bay Sands, длинными абзацами, разбивка инструкций на короткие последовательные шаги значительно упрощает их восприятие для людей и голосовых помощников. Руководства со скриншотами, такие как «Как добраться до Marina Bay Sands на метро» , представленные в виде маркированных или нумерованных списков, работают исключительно хорошо. Они не только удобны для просмотра на мобильных устройствах, но и при чтении вслух Google Assistant или Siri инструкции остаются чёткими и выполнимыми.
Согласуйте контент с реальными поисковыми сценариями
Немедленные потребности или повседневные ситуации часто становятся причиной голосовых запросов. Понимание типичных поисковых контекстов помогает создавать контент, который напрямую отвечает на намерения пользователя.
Например, сайт ресторана в Сингапуре может включать контент, отвечающий на вопрос: «Какие халяльные рестораны открыты рядом с Орчард-роуд после 21:00?» Это гарантирует, что пользователи получат практичные ответы, соответствующие реальным ситуациям, повышая вероятность вовлечения через голосовой поиск.
Готовы выйти на новые рынки? Попробуйте наш сервис автоматического перевода бесплатно в течение 1 месяца без риска. Кредитная карта не требуется!
Conclusion
Тенденции голосового поиска в Юго-Восточной Азии меняют то, как люди ищут информацию: они больше не вводят короткие ключевые слова, а задают вопросы напрямую, словно разговаривая с другом. Поскольку задавать вопросы голосом естественнее и учитывает культурный контекст, SEO больше не может сосредотачиваться исключительно на жёстких ключевых словах. Брендам необходимо понимать, как пользователи в этом регионе смешивают языки, используют местный сленг и даже включают религиозные или вежливые элементы в свои вопросы.
Техническая SEO-оптимизация для голосового поиска теперь является новой основой для сохранения конкурентоспособности. Компании, которые адаптируют структуру своего контента к разговорным вопросам, используют правильную разметку схемы и выполняют глубокую локализацию, будут легче появляться в результатах голосового поиска. Если вы хотите автоматически оптимизировать многоязычный контент и сделать его SEO-дружественным без создания множества ручных версий, Linguise — это самое практичное решение для начала.