Voice search -trends in Zuidoost-Azië veranderen de manier waarop gebruikers met content omgaan, waardoor technische SEO zich moet aanpassen aan lokale taalkundige en culturele gedragingen. Naarmate conversationele, op vragen gebaseerde zoekopdrachten toenemen, moeten bedrijven zichtbaar blijven door voor deze patronen te optimaliseren.
Culturele en meertalige nuances, zoals code-switching, lokaal slang en dialectvariaties, beïnvloeden hoe zoekopdrachten worden geïnterpreteerd. SEO-strategieën moeten zich richten op natuurlijke taal, long-tail zoekopdrachten en een correcte technische setup, zoals schema-markup en meertalige indexering.
Adoptietrends en belangrijke markten voor spraakzoekopdrachten in Zuidoost-Azië
De trend van de adoptie van spraakzoekopdrachten in Zuidoost-Azië laat een aanzienlijke groei zien, wat een weerspiegeling is van veranderingen in consumentengedrag waarbij steeds vaker spraaktechnologie in het dagelijks leven wordt gebruikt. Landen zoals Indonesië, Thailand, de Filipijnen en Vietnam zijn de belangrijkste markten die deze trend aandrijven, ondersteund door toenemende internetpenetratie en een technisch onderlegde jonge bevolking. Digital Market-gegevens tonen aan dat gebruikers steeds vaker overschakelen van tekst naar spraakzoekopdrachten, met de nadruk op volledige zinnen en conversationele zinnen.
Volgens Demand Sage-gegevens maakt ongeveer 20,5% van de wereldwijde internetgebruikers gebruik van spraakzoekopdrachten, en het totale aantal actieve spraakassistenten zal naar verwachting 8,4 miljard eenheden bereiken in 2025. Hoewel er geen specifieke gegevens beschikbaar zijn voor Zuidoost-Azië, wijst deze wereldwijde trend erop dat de regio aanzienlijk bijdraagt aan deze groei.
Grote technologiebedrijven zoals Google, Amazon en Microsoft hebben hun investeringen in Zuidoost-Azië opgevoerd, wat hun vertrouwen in het potentieel van de markt weerspiegelt. Zo kondigde Google een investering van $2 miljard aan om datacenters en clouddiensten in Maleisië te bouwen, die spraakgestuurde zoekdiensten zullen ondersteunen.
Dus ondanks uitdagingen zoals taal- en dialectdiversiteit is het marktpotentieel voor voice search in Zuidoost-Azië enorm, en bedrijven die hun strategieën kunnen afstemmen op lokale behoeften zullen een aanzienlijk concurrentievoordeel hebben.
Culturele en meertalige nuances die spraakzoekopdrachten vormgeven
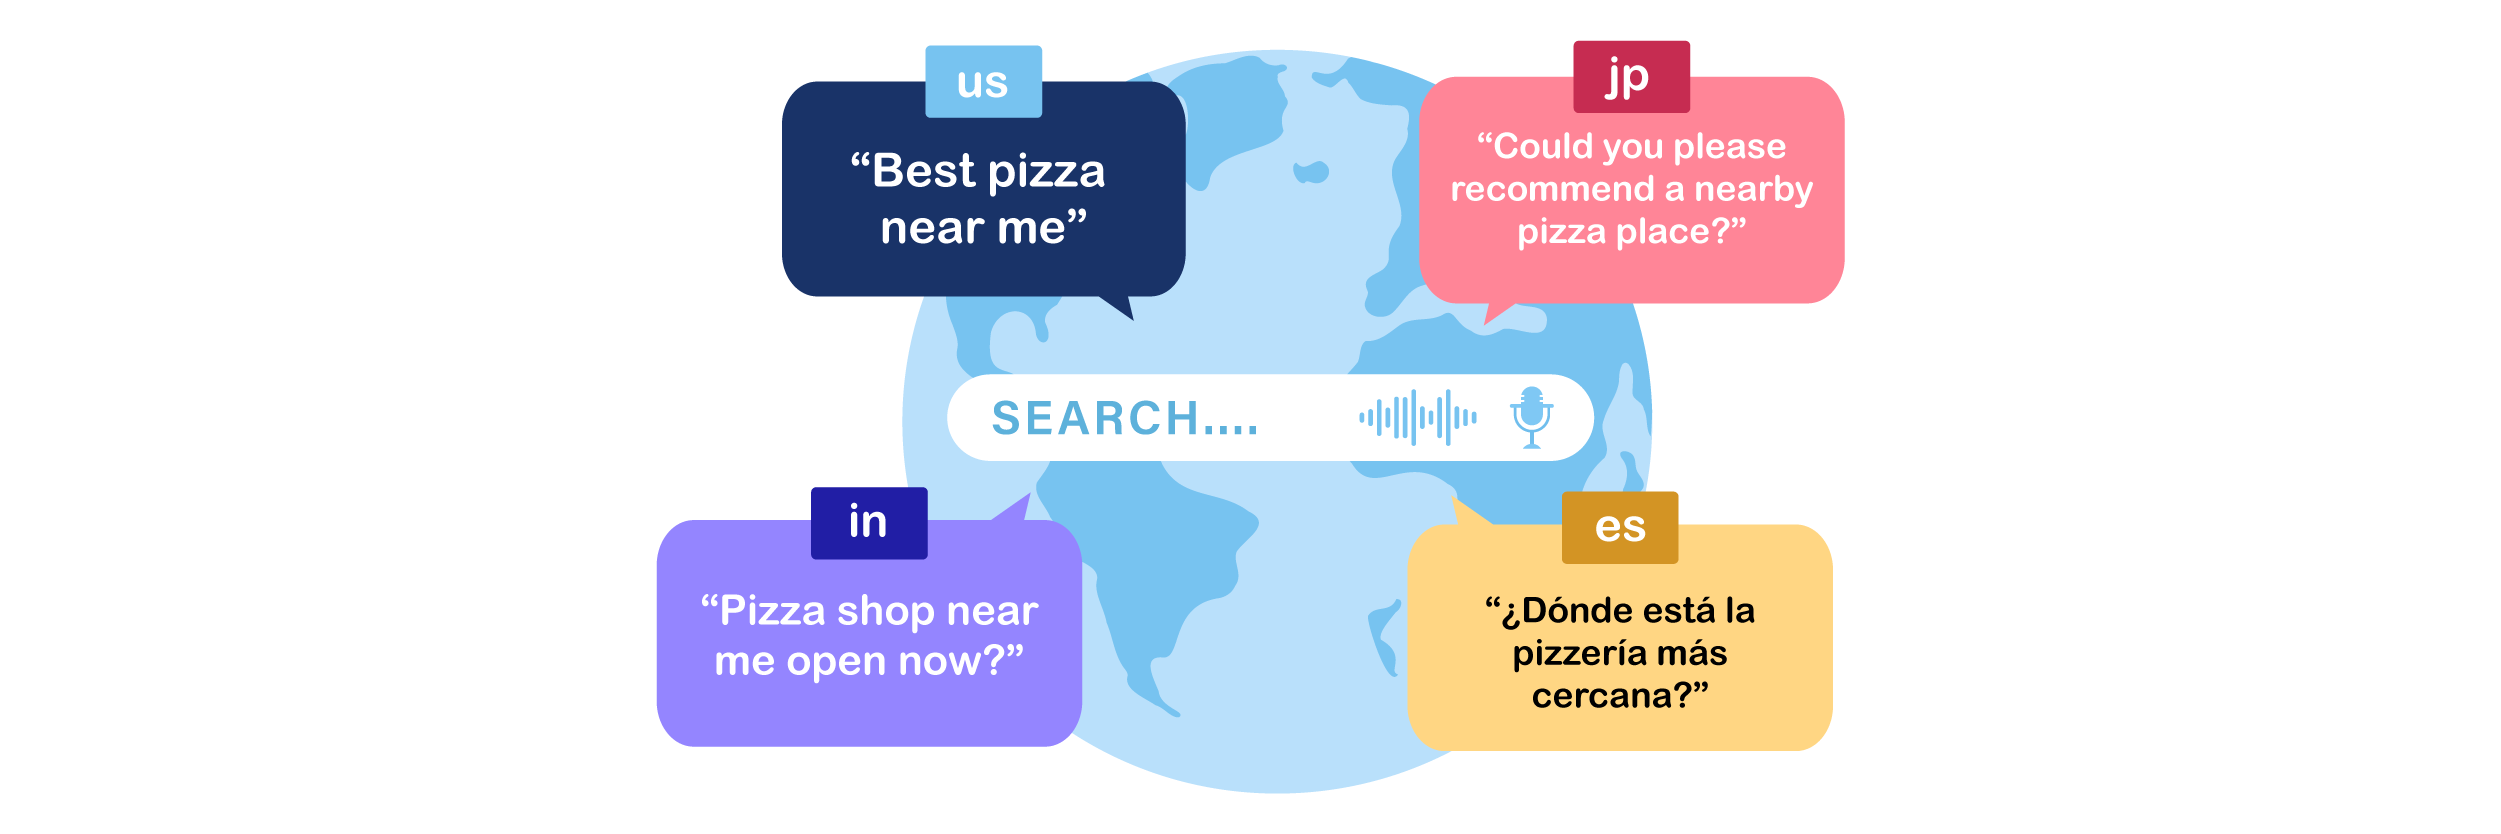
Culturele en taalkundige diversiteit beïnvloedt het gedrag rond spraakzoekopdrachten in Zuidoost-Azië in hoge mate. Gebruikers combineren vaak talen, dialecten en informeel taalgebruik op manieren die dagelijkse communicatiepatronen weerspiegelen, wat zoekmachines voor unieke uitdagingen stelt bij het nauwkeurig interpreteren van zoekopdrachten. Inzicht in deze nuances is cruciaal voor het optimaliseren van content voor spraakzoekopdrachten.
Code-switching in het dagelijks taalgebruik
In Zuidoost-Azië is het gebruikelijk dat mensen midden in een zin van taal wisselen, bijvoorbeeld door de lokale taal te combineren met Engels. Deze codewisseling gebeurt op natuurlijke wijze in gesprekken en beïnvloedt hoe zoekmachines spraakzoekopdrachten interpreteren. Een zoekopdracht kan trefwoorden uit twee talen bevatten, waardoor het belangrijk is dat content beide talen aanspreekt.
SEO-strategieën moeten meertalige zinnen opnemen in belangrijke content, koppen en metadata. Het herkennen van de gangbare code-switching-patronen zorgt ervoor dat zoekopdrachten in beide talen relevante resultaten kunnen opleveren, wat de algehele zichtbaarheid en gebruikerservaring verbetert.
Dialecten, accenten en informele taalpatronen
Regionale dialecten en accenten kunnen de uitspraak aanzienlijk veranderen, wat leidt tot misinterpretatie in spraakherkenningssystemen. Informeel taalgebruik, waaronder samentrekkingen of lokale uitdrukkingen, voegt een extra laag van complexiteit toe. Zoekmachines kunnen moeite hebben om deze zoekopdrachten correct te matchen met standaardcontent.
Om dit aan te pakken, kunnen contentmakers alternatieve spellingen, fonetische variaties of informele termen opnemen in content en metadata. Deze aanpak helpt ervoor te zorgen dat spraakzoekopdrachten uit diverse regio's correct worden begrepen en gekoppeld, wat de zoeknauwkeurigheid voor verschillende doelgroepen verbetert.
Het mengen van Engels met lokale slang in vragen
Veel gebruikers mengen Engelse woorden met lokaal slang in hun zoekopdrachten, vooral bij tech-, entertainment- of productgerelateerde onderwerpen. Een gebruiker zou bijvoorbeeld kunnen zeggen: “Best gadget murah di Jakarta,” een combinatie van Engels en Indonesisch. Het negeren van deze hybride vormen kan ertoe leiden dat u zoekkansen mist.
Het optimaliseren van content voor spraakzoekopdrachten vereist het identificeren van veelgebruikte slang en het opnemen daarvan naast standaardtaaltermijnen. Hierdoor kunnen zoekmachines conversationele zoekopdrachten effectiever matchen, wat de kans vergroot dat je verschijnt in resultaten voor zoekopdrachten in gemengde talen.
Verkorte zinnen versus zoekopdrachten in volledige zinnen
Anders dan bij getypte zoekopdrachten bestaan spraakzoekopdrachten vaak uit volledige zinnen in plaats van losse trefwoorden. Gebruikers kunnen vragen: “Waar kan ik goedkope nasi lemak vinden in Kuala Lumpur?” in plaats van “goedkope nasi lemak KL” te typen. Deze verschuiving naar een meer conversationele formulering verandert hoe content moet worden gestructureerd om directe antwoorden te bieden.
Om zich aan te passen, moet content beknopte antwoorden in natuurlijke taal bieden en vraaggebaseerde koppen of FAQ-secties bevatten. Antwoorden in volledige zinnen formuleren vergroot de kans dat spraakassistenten nauwkeurige resultaten kunnen extraheren en aan gebruikers kunnen leveren.
Gebruik van beleefdheidsvormen en eretitels in lokale talen
In sommige Zuidoost-Aziatische talen, zoals Thai of Javaans, gebruiken gebruikers beleefdheidsvormen of eretitels in hun spraakopdrachten. Dit komt vooral vaak voor bij het spreken tegen apparaten die als ‘formeel’ worden ervaren of in openbare settings. Het negeren van deze vormen kan de zoeknauwkeurigheid verminderen.
Contentmakers moeten overwegen om waar relevant respectvolle termen of alternatieve formuleringen op te nemen. Dit helpt om de intentie van de gebruiker te matchen, zodat zoekopdrachten met beleefd taalgebruik nog steeds tot nauwkeurige en relevante resultaten leiden.
Religieuze en culturele terminologie in zoekintentie
Gebruikers nemen vaak religieuze of culturele termen op in hun spraakzoekopdrachten, wat lokale gewoonten, feestdagen of rituelen weerspiegelt. Zoekopdrachten kunnen zinnen bevatten zoals “Ramadan-recept” of “openingstijden van de tempel in Bali”, die mogelijk niet voorkomen in standaard SEO-trefwoordenonderzoek.
Het opnemen van cultureel relevante terminologie en context in content helpt om aan te sluiten bij deze gebruikersintenties. Bedrijven en contentmakers kunnen hun zichtbaarheid verbeteren door cultureel beïnvloede zoekopdrachten te anticiperen en directe antwoorden te bieden in content die is afgestemd op lokale contexten.
Uitspraakvariaties die ASR beïnvloeden
Automatische spraakherkenning (ASR) kan woorden verkeerd interpreteren door regionale of leeftijdsgebonden uitspraakverschillen. Een woord dat in Jakarta wordt uitgesproken, kan bijvoorbeeld iets anders klinken in Surabaya of Penang, wat fouten kan veroorzaken bij het matchen van spraakopdrachten.
Om dit te beperken, kunnen contentmakers rekening houden met veelvoorkomende uitspraakvarianten, fonetische spellingen opnemen of FAQ-achtige content gebruiken die natuurlijke spraak weerspiegelt. Dit zorgt ervoor dat spraakzoekopdrachten correct worden begrepen en gekoppeld aan relevante content, wat de zoekeffectiviteit voor diverse gebruikersgroepen verbetert.
Technische SEO-uitdagingen bij voice search
Voice search introduceert unieke technische SEO uitdagingen, omdat zoekopdrachten vaak langer, conversationeler en meertalig zijn. Om ervoor te zorgen dat content vindbaar, correct geïndexeerd en gestructureerd is voor directe antwoorden, is zorgvuldige optimalisatie nodig. Bedrijven moeten hun SEO-strategieën aanpassen om aan deze veranderende eisen te voldoen.
Omgaan met long-tail- en conversationele zoekopdrachten
Spraakzoekopdrachten zijn doorgaans langer dan getypte zoekopdrachten en hebben vaak de vorm van natuurlijke zinnen. Dit vormt uitdagingen voor SEO, omdat standaard zoekwoordtargeting mogelijk niet alle manieren dekt waarop gebruikers hun vragen formuleren. Content die zich alleen richt op korte zoekwoorden kan waardevol verkeer van spraakzoekopdrachten mislopen.
De onderstaande schermafbeelding toont het verschil tussen tekstgebaseerde zoekopdrachten, zoals “cheap hotel bali”, en spraakzoekopdrachten met volledige zinnen zoals “Where can I find a cheap hotel in Bali for 2 nights?”.
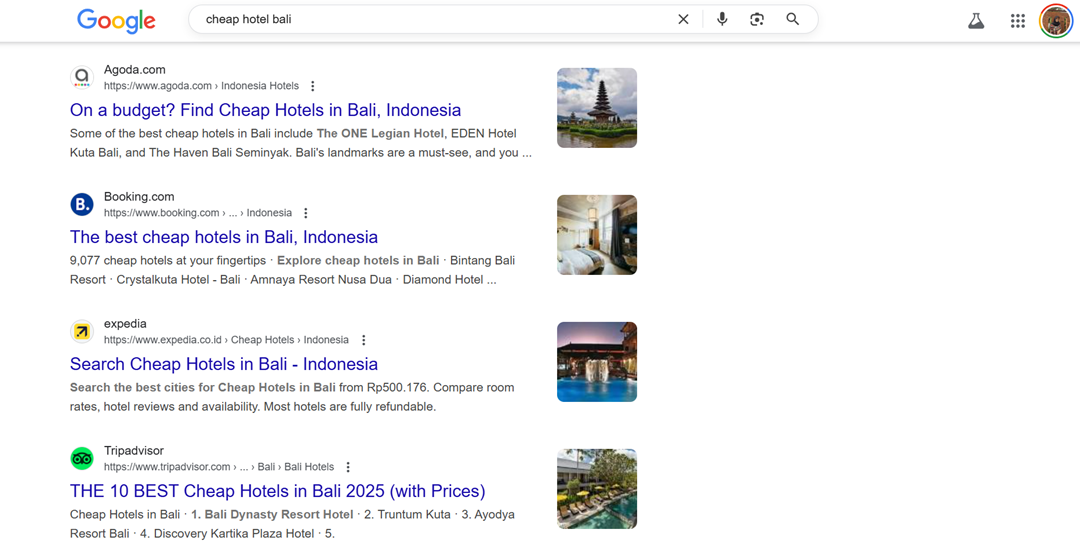
Hoewel beide hetzelfde doel hebben, is de taalstructuur heel anders, en als content alleen geoptimaliseerd is voor korte zoekwoorden, kunnen dit soort conversatiegerichte zoekresultaten gemist worden.
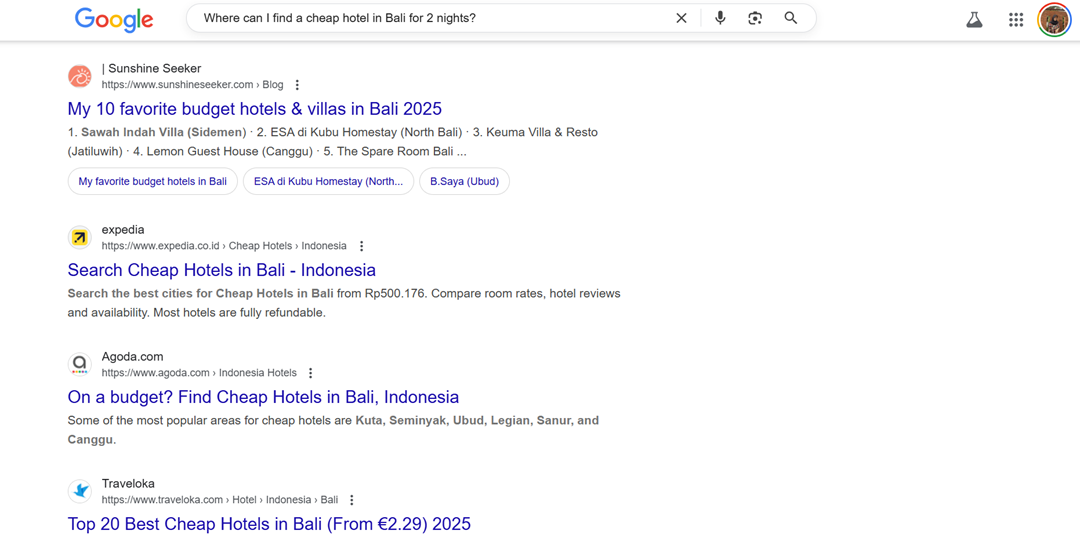
Om dit aan te pakken, moeten websites long-tail keywords integreren die zoekopdrachten in volledige zinnen weerspiegelen. Het analyseren van echte gebruikerszoekopdrachten en het bijwerken van content met conversationele taal helpt zoekmachines om zoekopdrachten beter te koppelen aan relevante pagina's, wat de zichtbaarheid voor spraakzoekopdrachten verbetert.
Het structureren van de inhoud voor directe antwoorden
Spraakassistenten geven de voorkeur aan content die duidelijke, beknopte antwoorden biedt. Een uitdaging is het structureren van informatie zodat deze gemakkelijk kan worden geëxtraheerd en hardop voorgelezen. Spraakzoekplatforms kunnen pagina's met dichte alinea's of onduidelijke opmaak over het hoofd zien.
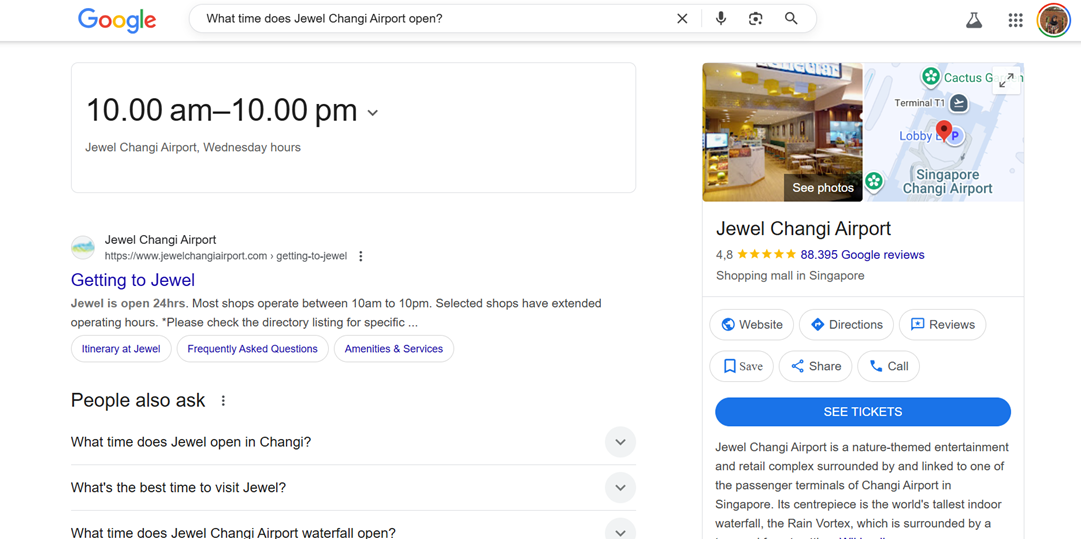
Het gebruik van koppen, opsommingstekens en korte alinea's helpt content eruit springen als een direct antwoord. FAQ-secties en gemarkeerde samenvattingen maken het voor zoekmachines gemakkelijker om de meest relevante informatie te identificeren, wat de kans vergroot om te worden opgenomen in spraakantwoorden. Wanneer bijvoorbeeld een van de volgende zoekwoorden, “What time does Jewel Changi Airport open?”, op Google wordt gezocht, verschijnt onmiddellijk een snippet met openingstijden en relevante FAQ's.
Optimaliseren voor op vragen gebaseerde zoekpatronen
Veel spraakzoekopdrachten zijn geformuleerd als vragen zoals “Hoe kom ik bij de tempel Tanah Lot?” Traditionele SEO richt zich vaak op trefwoorden in plaats van op de intentie achter de vraag, wat de zichtbaarheid beperkt. Dit creëert de uitdaging om verschillende mogelijke zoekopdrachten te voorspellen en te optimaliseren.
Om dit te overwinnen, moet content worden gemaakt met vraag-en-antwoordformaten. Door koppen te gebruiken die veelvoorkomende vragen nabootsen en antwoorden op een natuurlijke manier te integreren, worden spraakzoekopdrachten nauwkeurig aan content gekoppeld, wat de relevantie van zoekresultaten verbetert.
Verbetering van crawlbaarheid en indexeerbaarheid in meerdere talen
Meertalige content voegt complexiteit toe aan technische SEO voor spraakzoekopdrachten. Het is een uitdaging om ervoor te zorgen dat zoekmachines pagina's in meerdere talen kunnen crawlen en indexeren, vooral wanneer sites verschillende URL's of subdomeinen gebruiken voor gelokaliseerde content.
Correcte hreflang-tags, taalspecifieke sitemaps en overzichtelijke URL-structuren helpen zoekmachines om de taal en regionale targeting te begrijpen. Dit verbetert de indexeerbaarheid en zorgt ervoor dat gebruikers de meest relevante resultaten in hun voorkeurstaal krijgen.
Dubbele content beheren in gelokaliseerde versies
Dubbele content kan ontstaan wanneer vergelijkbare pagina's in verschillende talen of regio's worden gemaakt. Dit is een grote uitdaging, omdat zoekmachines moeite kunnen hebben om te bepalen welke versie moet worden gerangschikt, wat de zichtbaarheid voor spraakzoekopdrachten vermindert. Het gebruik van canonical tags en ervoor zorgen dat elke gelokaliseerde pagina unieke, relevante content biedt, helpt dit probleem te beperken. Een goede differentiatie van content zorgt ervoor dat spraakzoekopdrachten naar de meest geschikte pagina worden geleid, waardoor de gebruikerservaring en zoekprestaties behouden blijven.
Het handmatig beheren hiervan over tientallen taalversies kan echter tijdrovend zijn.
Een vertaal- en lokalisatieoplossing zoals Linguise genereert automatisch SEO-vriendelijke URL's, past canonical tags toe en zorgt ervoor dat elke vertaalde versie wordt behandeld als een unieke pagina in plaats van dubbele content, waardoor bedrijven meertalige optimalisatie voor spraakzoekopdrachten kunnen opschalen zonder het risico op indexeringsconflicten.
Schema-markup-dekking voor spraakgestuurde SERP's
Spraakzoekopdrachten vertrouwen vaak op gestructureerde data om snel relevante antwoorden te identificeren. Een uitdaging is ervoor te zorgen dat schema-markup consistent wordt geïmplementeerd op alle pagina's, inclusief meertalige content en gelokaliseerde versies.
Het gebruik van schematypen, zoals FAQ, HowTo en Product, maakt het voor zoekmachines gemakkelijker om informatie te extraheren voor gesproken antwoorden. Regelmatige audits en updates van gestructureerde data helpen de nauwkeurigheid te behouden en de zichtbaarheid in spraakgestuurde zoekresultaten te verbeteren.
Contentstrategie voor optimalisatie van spraakzoekopdrachten
Het optimaliseren van content voor spraakzoekopdrachten vereist een verschuiving van traditionele SEO-praktijken. Omdat spraakzoekopdrachten conversationeel en vaak vraaggebaseerd zijn, moet content zo worden gestructureerd dat deze vragen op een natuurlijke manier beantwoordt, gemakkelijk te verwerken is en de werkelijke intentie van de gebruiker weerspiegelt. Een strategische aanpak zorgt ervoor dat content vindbaar is en goed scoort voor spraakzoekopdrachten.
Optimaliseer voor natuurlijke taal en op vragen gebaseerde zoekwoorden
Spraakzoekopdrachten worden vaak in volledige zinnen geformuleerd in plaats van in korte trefwoorden. Daarom is het essentieel om natuurlijke taalzinnen en op vragen gebaseerde trefwoorden te targeten, zoals “Waar kan ik de beste koffie in Frankrijk vinden?” in plaats van simpelweg “beste koffie Frankrijk.”
Het opnemen van deze zinnen in koppen, FAQ's en bodytekst helpt zoekmachines om conversationele zoekopdrachten te matchen. Een reiswebsite kan bijvoorbeeld een FAQ-pagina maken met het antwoord op “Wat zijn de topattracties in Ubud?” om rechtstreeks op spraakzoekverkeer te mikken.
Lokaliseer content verder dan vertaling
Gebruikers zoeken vaak in hun moedertaal en verwachten cultureel relevante content. Alleen content vertalen is niet genoeg; content lokaliseren moet voorbeelden, valuta, meeteenheden en context aanpassen aan lokale gebruiken.
Een receptensite die zich bijvoorbeeld op Maleisië richt, moet lokale ingrediëntnamen en maateenheden gebruiken die Maleisische gebruikers kennen, in plaats van letterlijke vertalingen. Deze aanpak verbetert de betrokkenheid en zorgt ervoor dat voice search zinvolle resultaten oplevert.
Creëer spraakvriendelijke formaten
Content moet zo gestructureerd zijn dat spraakassistenten deze gemakkelijk hardop kunnen voorlezen. Korte alinea's, opsommingstekens, genummerde stappen en duidelijke koppen helpen spraakassistenten om informatie efficiënt te extraheren.
Een gids over ‘Hoe je Gardens by the Bay bezoekt’ met genummerde aanwijzingen vanaf Bayfront MRT en belangrijke tips in opsommingstekens stelt gebruikers bijvoorbeeld in staat om beknopte gesproken instructies te ontvangen, wat de bruikbaarheid voor spraakzoekopdrachten verbetert.
Gebruik een conversationele toon zonder autoriteit te verliezen
Gebruikers van spraakzoekopdrachten verwachten een natuurlijke, gemakkelijk te begrijpen toon. Content moet echter ook geloofwaardig en gezaghebbend blijven, vooral bij technische, gezondheids- of financiële onderwerpen. Te casual schrijven kan het vertrouwen schaden, terwijl te formeel schrijven robotachtig kan klinken. De sleutel is dus de juiste balans vinden tussen conversationeel en informatief.
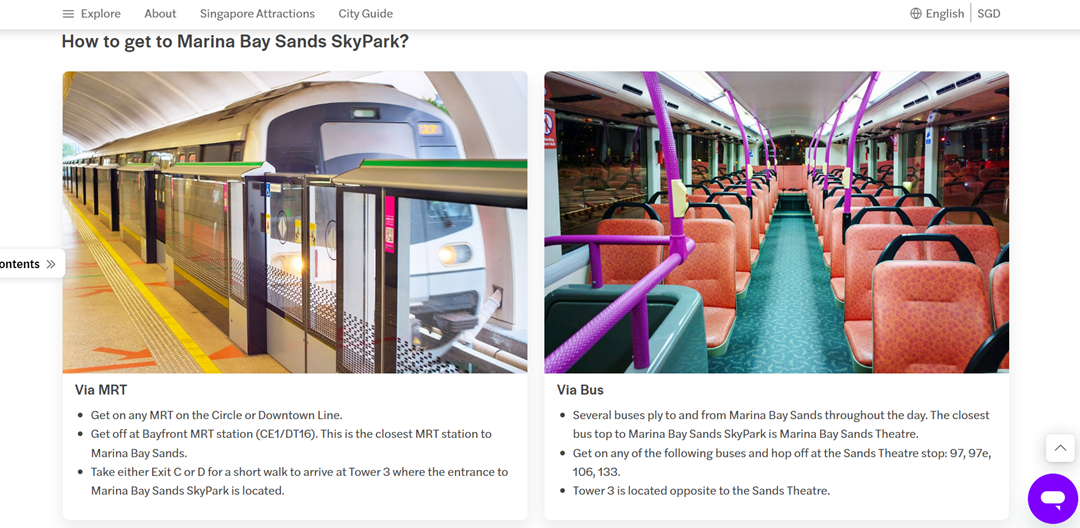
In plaats van routebeschrijvingen naar een plek zoals Marina Bay Sands in lange paragrafen te beschrijven, maakt het opdelen van de instructies in korte, opeenvolgende stappen het voor menselijke lezers en spraakassistenten veel gemakkelijker om te verwerken. Handleidingen met schermafbeeldingen zoals ‘Hoe ga je naar Marina Bay Sands via de MRT’ weergegeven in opsommingstekens of genummerde lijsten werken uitzonderlijk goed. Ze zijn niet alleen scanbaar op mobiel, maar wanneer ze hardop worden voorgelezen door Google Assistant of Siri, blijven de instructies duidelijk en uitvoerbaar.
Stem content af op realistische zoekscenario's
Directe behoeften of alledaagse situaties liggen vaak ten grondslag aan spraakzoekopdrachten. Inzicht in veelvoorkomende zoekcontexten helpt bij het creëren van content die direct inspeelt op de intentie van de gebruiker.
Een restaurantwebsite in Singapore kan bijvoorbeeld content opnemen die antwoord geeft op de vraag: “Welke halalrestaurants zijn na 21.00 uur open in de buurt van Orchard Road?” Zo krijgen gebruikers praktische antwoorden die aansluiten bij echte situaties, wat de kans op betrokkenheid via spraakzoekopdrachten vergroot.
Conclusie
Trends in spraakzoekopdrachten in Zuidoost-Azië veranderen de manier waarop mensen naar informatie zoeken: ze typen niet langer korte trefwoorden, maar stellen rechtstreeks vragen alsof ze met een vriend praten. Omdat vragen stellen via spraak natuurlijker en cultureel contextueler is, kan SEO zich niet langer uitsluitend richten op starre trefwoorden. Merken moeten begrijpen hoe gebruikers in deze regio talen mengen, lokaal slang gebruiken en zelfs religieuze of beleefdheidselementen in hun vragen verwerken.
Technische SEO voor spraakzoekopdrachten is nu de nieuwe basis om concurrerend te blijven. Bedrijven die hun contentstructuur aanpassen aan conversationele vragen, de juiste schema-markup gebruiken en diepgaande lokalisatie uitvoeren, verschijnen gemakkelijker in de resultaten van spraakzoekopdrachten. Als je meertalige content automatisch en SEO-vriendelijk wilt optimaliseren zonder veel handmatige versies te maken, Linguise is de meest praktische oplossing om mee te beginnen.